IT-инфраструктура туроператора и отеля к пиковым нагрузкам: практический чек-лист отказоустойчивости
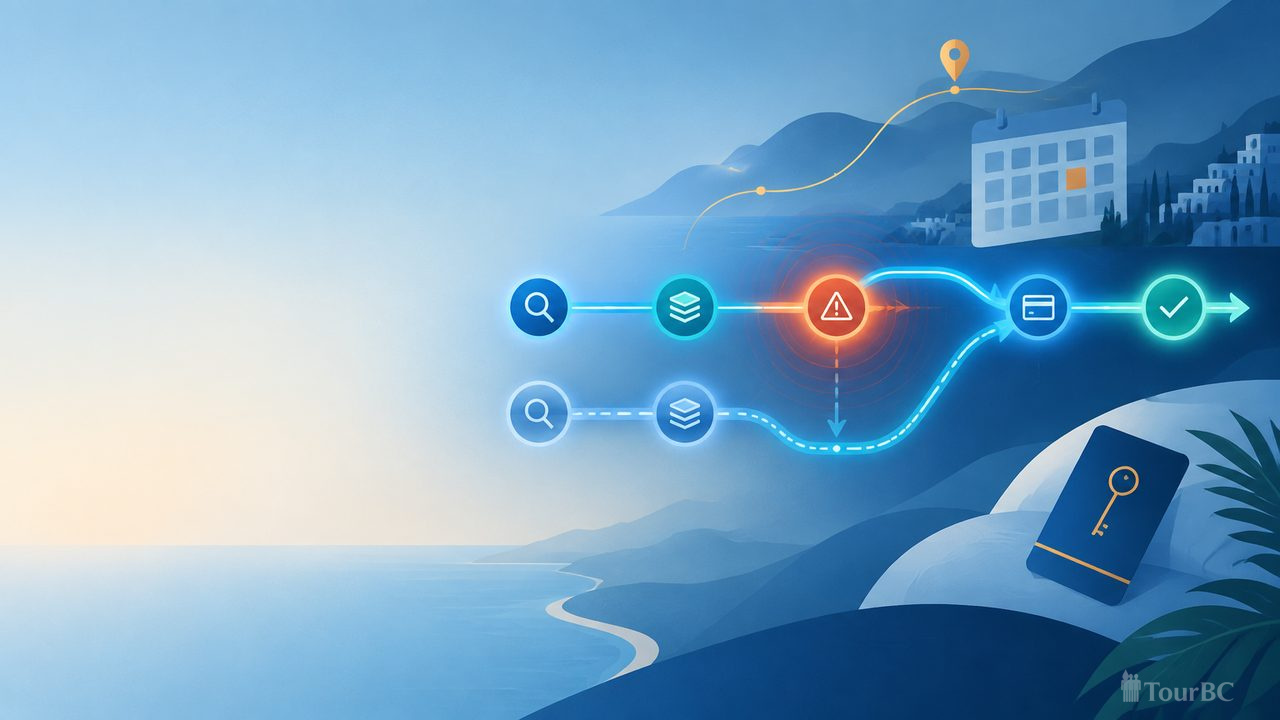
Пиковая нагрузка в туризме проверяет не «сервер вообще», а конкретную цепочку. Клиент ищет тур или номер, система проверяет наличие, считает цену, принимает оплату и выдаёт подтверждение. Обмен данными с внешними поставщиками входит в ту же цепочку, и если ломается одно звено, страдает весь поток. Поэтому чек-лист построен по потокам, а не по серверам.
Для каждого блока указано, что проверить, какой сигнал считать тревожным, как протестировать и кто отвечает. Последние два пункта, «сигнал» и «ответственный», это практическая рамка для аудита, а не требование стандартов. Конкретные пороги и роли каждая компания определяет сама.
1. Определите критические потоки и цели восстановления
Начните с перечня потоков, без которых бизнес не зарабатывает: поиск и расчёт, проверка наличия, бронирование, оплата, выдача подтверждения, обмен с поставщиками. Для каждого из них Microsoft рекомендует заранее определить SLO, RTO и RPO: какая доступность допустима, за какое время сервис должен быть восстановлен и сколько данных можно потерять.
- Что проверить: записаны ли для каждого потока SLO, RTO и RPO и назван ли владелец.
- Тревожный сигнал: цели не сформулированы или заявлены, но ни разу не проверялись. Microsoft подчёркивает, что гарантировать цели восстановления без полноценного тестирования нельзя.
- Как протестировать: провести восстановление по сценарию и сравнить фактическое время и потери данных с целями.
- Кто отвечает: владелец бизнес-процесса вместе с руководителем IT.
Подробнее о постановке целей: Microsoft Azure Well-Architected: Defining reliability targets.
2. Рассчитайте пик и проверьте квоты
AWS советует начинать с проверки квот сервисов, пропускной способности и сетевой топологии. Архитектура при этом должна автоматически масштабироваться, обнаруживать сбои и самовосстанавливаться.
- Что проверить: ожидаемый пиковый трафик по каждому потоку, квоты облачных и внешних сервисов, пропускную способность каналов.
- Тревожный сигнал: пик не рассчитан или расчёт упирается в неизвестный лимит.
- Как протестировать: нагрузочное испытание с пиковыми значениями на среде, максимально близкой к production.
- Кто отвечает: архитектор или технический директор, при необходимости вместе с поставщиком облака.
Источник: AWS Well-Architected Framework: Reliability.
3. Зарезервируйте компоненты
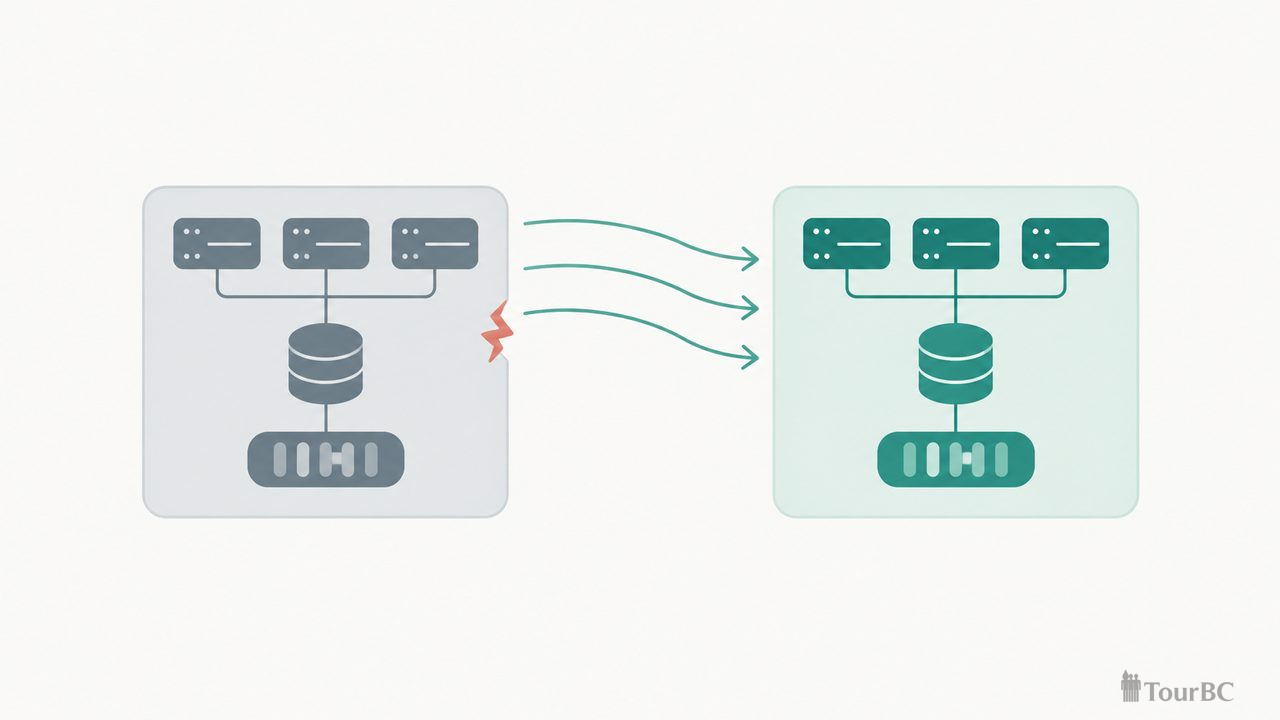
Если нагрузка размещена в нескольких зонах доступности, отказ одной зоны изолируется, а запросы обслуживают резервные зоны. Для более серьёзных сценариев AWS описывает активный и резервный регионы с переключением трафика.
- Что проверить: работают ли сайт, booking engine, API, базы данных и очереди минимум в двух зонах доступности; определён ли порядок переключения на резервный регион, если он нужен.
- Тревожный сигнал: какой-то компонент критического потока существует в единственном экземпляре.
- Как протестировать: отключить зону или экземпляр в тестовой среде и убедиться, что запросы продолжают обслуживаться.
- Кто отвечает: инфраструктурная команда.
Источник: AWS Well-Architected: Shared Responsibility Model for Resiliency.
4. Масштабируйте горизонтально и заранее
Microsoft рекомендует делать сервисы горизонтально масштабируемыми и stateless. Приложение не должно рассчитывать, что последовательные запросы клиента попадут на один и тот же экземпляр. Масштабировать нужно не только вычислительные ресурсы, но и базы данных, очереди и другие компоненты критического потока. Ещё стоит следить за временем запуска новых экземпляров и за самими операциями масштабирования.
Для предсказуемых сезонных или событийных пиков AWS поддерживает scheduled scaling: ёмкость растёт по расписанию. Predictive scaling наращивает её заранее по историческим закономерностям, анализируя до 14 дней истории и строя прогноз на следующие 48 часов. Прежде чем включать автоматическое масштабирование, прогноз рекомендуется оценить в режиме forecast only.
- Что проверить: хранится ли состояние сессии и корзины вне экземпляра приложения; масштабируются ли база и очереди; как быстро запускаются новые экземпляры; настроено ли масштабирование по расписанию на известные пики.
- Тревожный сигнал: новые экземпляры не успевают включиться до роста трафика, а база остаётся узким местом при растущем числе приложений.
- Как протестировать: нагрузочный тест с замером времени запуска и поведения базы и очередей; прогноз predictive scaling в режиме forecast only.
- Кто отвечает: разработка и инфраструктурная команда.
Источники: Microsoft Azure Well-Architected: Reliable scaling strategy, Amazon EC2 Auto Scaling: Choose your scaling method, Amazon EC2 Auto Scaling: How predictive scaling works.
5. Защитите API: лимиты, очереди, таймауты, повторы
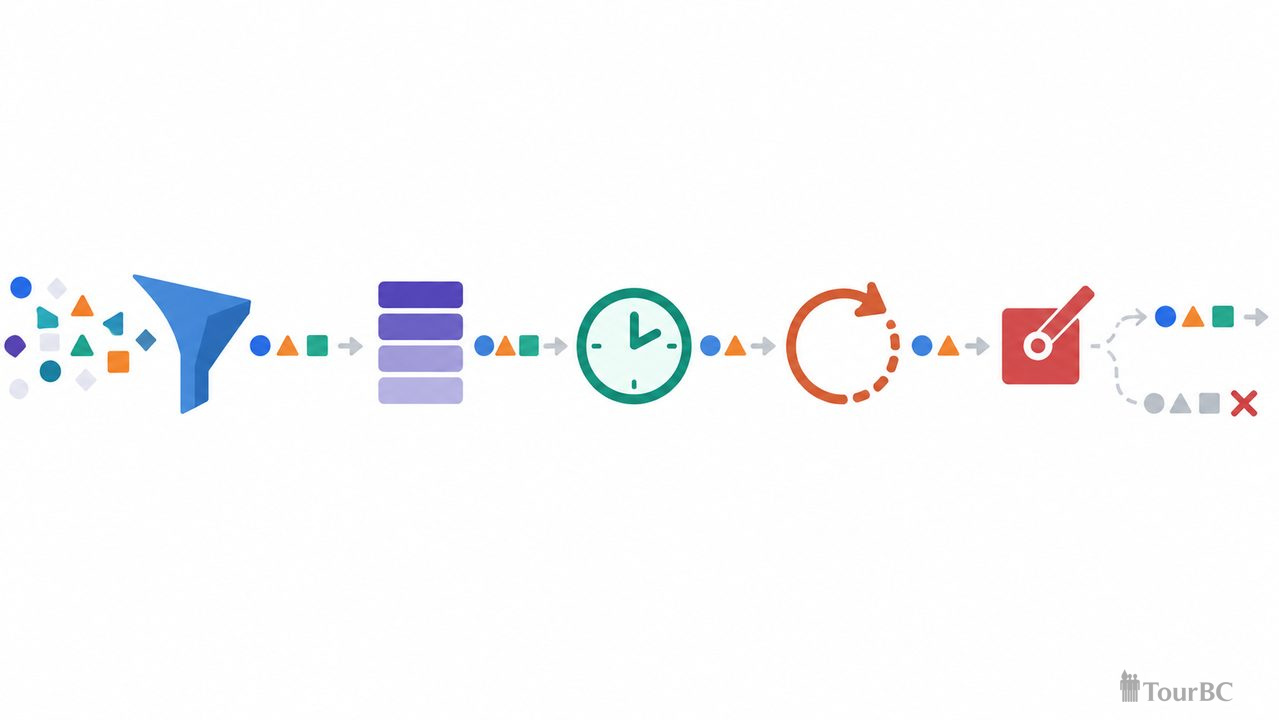
AWS относит throttling, retries, очереди, таймауты и аварийные переключатели к базовым механизмам предотвращения отказов в распределённых системах. Для туроператора и отеля это касается и собственных API, и вызовов внешних поставщиков, PMS и CRS.
- Что проверить: заданы ли ограничения запросов, таймауты на каждый внешний вызов и политика повторных попыток; есть ли очередь для операций, которые можно отложить, и аварийный переключатель для проблемной интеграции.
- Тревожный сигнал: зависший внешний вызов блокирует ответ клиенту, повторы выполняются без ограничений.
- Как протестировать: имитировать медленный или недоступный ответ поставщика и посмотреть, как ведёт себя поток.
- Кто отвечает: разработка интеграций.
6. Учтите требования площадок к скорости и объёму данных
Google Hotel Prices использует live pricing-запросы с типичным лимитом ответа до 4000 миллисекунд. Если уложиться не удалось, конкретная возможность показа цены может быть потеряна. Поэтому время ответа ценового сервиса нужно измерять и держать под контролем: медленный ответ стоит показа.
Google также предупреждает, что при обновлении гостиничных цен может приходить много Query-сообщений, а ответы Transaction бывают очень большими. Чтобы уменьшить объём и число сообщений, рекомендуется Changed Pricing. Если при отправке ARI-сообщения произошла ошибка HTTP-соединения, Google советует повторить запрос через 1, 5 и 20 минут, а после трёх неудачных попыток прекратить отправку и обратиться в поддержку.
- Что проверить: укладывается ли ценовой сервис в лимит ответа; выдерживает ли инфраструктура всплеск Query-сообщений и крупные ответы; используется ли Changed Pricing; реализована ли схема повторов 1, 5 и 20 минут с остановкой после трёх неудач.
- Тревожный сигнал: время ответа приближается к лимиту, растёт доля потерянных показов цены, повторы идут чаще рекомендованного.
- Как протестировать: смоделировать пачку запросов при обновлении цен и сбой соединения при отправке ARI.
- Кто отвечает: команда интеграций и ревеню-менеджмент как потребитель данных.
Источники: Google Hotel Prices: Query Messages, Google Hotel Prices: Pricing Delivery Modes.
7. Настройте наблюдаемость
OpenTelemetry выделяет три основных типа телеметрии: traces, metrics и logs. Трассировка показывает путь одного запроса через API, приложение, очередь и базу данных, так что по ней проще понять, на каком звене поток застрял. Azure рекомендует постоянно измерять состояние системы по техническим и пользовательским показателям, следить за распределением нагрузки между резервными экземплярами и сохранять данные для расследования инцидентов.
- Что проверить: собираются ли метрики, логи и трассировки по каждому критическому потоку; есть ли пользовательские показатели, а не только загрузка серверов; видно ли распределение нагрузки между экземплярами; сохраняются ли данные для разбора инцидентов.
- Тревожный сигнал: о проблеме узнают от клиентов или поддержки, а не из мониторинга; нагрузка между резервными экземплярами распределена неравномерно.
- Как протестировать: на учениях проверить, как быстро команда находит по телеметрии искусственно созданную причину сбоя.
- Кто отвечает: инфраструктурная команда и разработка.
Источники: OpenTelemetry: Observability Primer, Microsoft Azure Well-Architected: Monitoring workload reliability.
8. Подготовьте восстановление и регулярно его проверяйте
NIST указывает, что планы восстановления нужно периодически проверять и повторно тестировать после изменений в организации или системе. Испытания должны охватывать восстановление на альтернативной платформе, внешние соединения, производительность и возврат к штатной работе. Последнее легко упустить: мало восстановиться, нужно ещё вернуться к обычной схеме.
AWS рекомендует регулярно тестировать функциональность, масштабирование, производительность и отказоустойчивость, в том числе через инъекцию отказов, chaos engineering и game days. Тестовая среда должна быть максимально близка к production.
- Что проверить: есть ли документированные процедуры восстановления и резервные копии, когда проводилось последнее испытание, повторяли ли его после крупных изменений.
- Тревожный сигнал: процедура существует только на бумаге, восстановление на альтернативной платформе не проверялось.
- Как протестировать: game day с отказом компонента, восстановление из копии, проверка внешних соединений и возврата к штатной работе.
- Кто отвечает: руководитель IT при участии бизнес-владельцев потоков.
Источники: NIST SP 800-34 Rev. 1: Contingency Planning Guide, AWS Well-Architected: How do you test reliability?.
Сценарии деградации: что делать, если нагрузка выше расчётной
Полностью исключить перегрузку нельзя, поэтому заранее решите, как система будет работать в ограниченном режиме. За основу можно взять механизмы, которые AWS считает базовыми: throttling, очереди, аварийные переключатели. Конкретные правила каждая компания задаёт исходя из своих потоков.
- Ограничение запросов. Лимиты на API защищают бронирование и оплату от наплыва менее важных обращений.
- Кэширование результатов поиска. Часть поисковых запросов можно обслуживать без обращения к поставщикам. Допустимую устарелость данных нужно согласовать заранее.
- Отключение второстепенных функций. Заранее определите, что можно выключить, чтобы освободить ресурсы для основного потока.
- Очереди. Операции, которые можно выполнить позже, стоит отделить от тех, что нужны клиенту сразу.
- Ручное бронирование и резервные каналы. Для критических потоков нужен описанный порядок работы сотрудников на случай, если автоматика недоступна. Готовых схем в исходных данных нет, поэтому такие процедуры компания определяет сама.
Для каждого сценария зафиксируйте, кто решает о включении, по какому сигналу и как система возвращается к штатной работе. Эти сценарии тоже нужно отрабатывать на учениях.
Краткий итог для аудита
- Перечислите критические потоки и задайте для них SLO, RTO и RPO.
- Рассчитайте пик, проверьте квоты, пропускную способность и сетевую топологию.
- Уберите единичные точки отказа: используйте несколько зон доступности.
- Сделайте приложения stateless, масштабируйте базы и очереди, настройте масштабирование по расписанию на известные пики.
- Задайте лимиты, таймауты, ограниченные повторы и аварийные переключатели.
- Сверьтесь с требованиями площадок по времени ответа и объёму сообщений.
- Соберите метрики, логи и трассировки по каждому потоку, включая пользовательские показатели.
- Опишите и регулярно отрабатывайте восстановление и сценарии деградации.
- PMS, channel manager и CRM в одном контуре: что показывает документация поставщиков

- SAMO-select с технологией бронирования

- Защита персональных данных в турбизнесе: чек-лист для агентства и отеля

- В Контур.Отеле появился расчет курортного сбора